想让海外 AI 推荐你的品牌?先避开这些 GEO 误区
Aurora
当海外消费者习惯直接在 ChatGPT、Perplexity、Claude 或 Google AI Overviews 里提问“哪款户外电源最耐用?”或“适合中小企业的 CRM 软件有哪些?”时,传统搜索的“10条蓝色链接”正在失去统治力。用户不再逐个点开网页比对,而是直接采纳 AI 生成的整合答案。
这就催生了出海营销的新战场——GEO(Generative Engine Optimization,生成式引擎优化)。
很多出海品牌已经意识到了 GEO 的重要性,但在实操中,却往往用过去做传统 SEO 的惯性思维去套用 AI 逻辑,结果钱花了不少,AI 的回答里依然查无此人。想让海外 AI 主动推荐你的品牌,必须先避开以下五个高频误区。
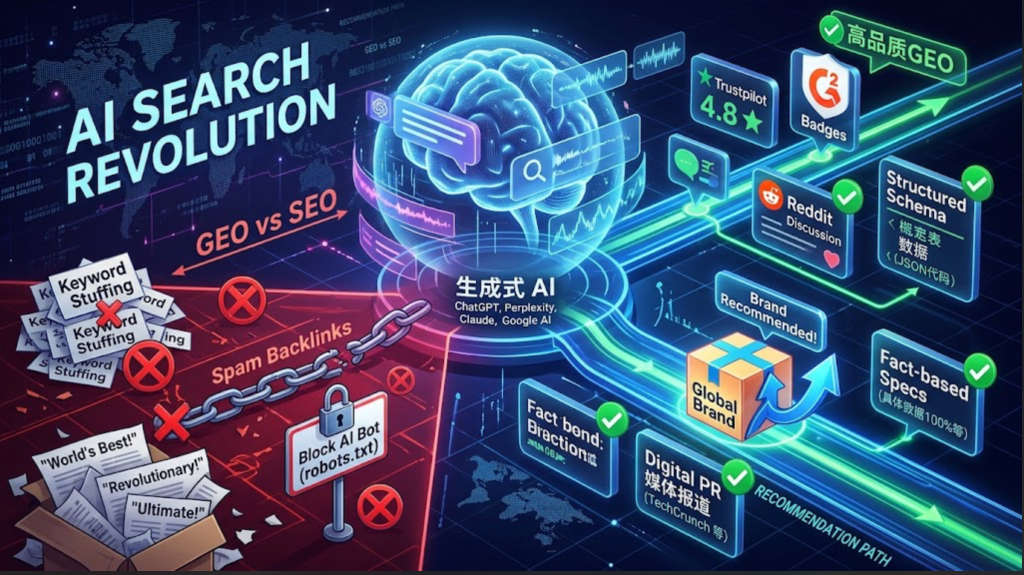
误区一:把 GEO 当作“换皮 SEO”,继续堆砌关键词与垃圾外链
在传统 SEO 时代,只要页面关键词密度够高、批量购买高权重外链,哪怕内容水一点,也能把排名顶上去。但把这套搬到 GEO 上,完全行不通。
生成式 AI 的底层逻辑是语义理解与上下文关联,而非简单的关键词匹配。当你还在纠结怎么把“best budget wireless earbuds”硬塞进文章十次时,AI 正在全网寻找关于耳机降噪、续航和佩戴舒适度的真实测评数据与多维度对比。此外,批量购买的垃圾外链不仅无法提升品牌在 AI 眼中的权重,反而可能因为内容质量低劣,被 AI 的检索系统(RAG)直接过滤。
- 破局策略: 放弃“关键词密度”执念,转向“语料结构化”与“上下文语境建设”。用自然、专业的母语回答用户在购买决策全周期中的具体问题(如适用场景、优缺点对比、技术参数),让 AI 在抓取时能直接提取出高信息密度的结论。
误区二:只围着品牌官网打转,忽视“全网共识(Consensus)”
很多品牌花了大力气重构官网博客,每天更新几十篇 AI 生成的行业文章,却发现 Perplexity 或 ChatGPT 推荐竞品时,引用的全是第三方网站的信源。
这是因为大模型在生成推荐时,极其看重“交叉验证”与“全网共识”。品牌官网自卖自夸说自己是“行业第一”,AI 会将其视为单一主观声明;但如果在 Reddit 社区讨论、Trustpilot 评价、G2 榜单、YouTube 垂直博主测评以及权威行业媒体(如 TechCrunch、Wirecutter)中,你的品牌被反复正面提及并与核心品类词绑定,AI 就会认定你的品牌具有高可信度。
- 破局策略: 将营销重心从“站内优化”扩展到“站外数字公关(Digital PR)与社区口碑”。主动布局 Reddit 真实讨论、Quora 专业问答、行业垂直测评媒体以及第三方评分平台,在全网构建起关于你品牌的“共识网络”。
误区三:内容满篇“营销黑话”,缺乏可被 AI 引用的“事实锚点”
翻开很多出海品牌的宣传页,满眼都是“World-leading(世界领先)”、“Revolutionary(革命性)”、“Ultimate comfort(极致舒适)”。这些形容词在人类读者看来是乏味的广告,在 AI 看来则是毫无价值的噪音。
大语言模型偏爱具体的、可量化的、有数据支撑的客观事实(Fact-based content)。如果 AI 无法从你的内容中提取出明确的规格、性能指标或第三方认证,它在整合对比表格或推荐理由时,就会直接略过你。
- 破局策略: 为内容植入高密度的“事实锚点”。
- 用数据代替形容词: 将“超长续航”改为“满电状态下连续播放 45 小时,支持 10 分钟快充续航 5 小时”。
- 增加结构化对比: 明确指出产品适合哪类人群、不适合哪类人群(例如:“专为小户型设计的静音跑步机,噪音低于 45 分贝,但不适合配速超过 12km/h 的专业马拉松跑者”)。这种客观、边界清晰的描述,最容易被 AI 直接引用为推荐理由。
误区四:屏蔽 AI 爬虫,或网站架构对机器“极不友好”
这是一个令人哭笑不得却极其普遍的技术误区:市场部在砸钱做 GEO,IT 部门却为了防止内容被白嫖或减轻服务器负担,在网站的 robots.txt 文件里把 GPTBot、ClaudeBot、PerplexityBot 全给屏蔽了。
另一个极端是,为了追求酷炫的视觉效果,官网大量使用复杂的 JavaScript 动态渲染,或者把核心产品参数全部做成精美的图片。这导致 AI 的实时检索爬虫在访问网页时,抓取到的是一片空白或乱码。
- 破局策略: 做好技术基建的“迎宾工作”。
- 检查爬虫权限: 确保
robots.txt向主流 AI 检索爬虫敞开大门。 - 部署 Schema 标记(结构化数据): 使用 JSON-LD 格式为产品添加价格、评分、库存、FAQ 等 Schema 标记,喂给机器最容易消化的标准格式。
- 文本化核心信息: 确保所有的参数表、对比图、用户痛点解答都有清晰的 HTML 文本(如 Markdown 表格、清晰的 H2/H3 标题层级)承载。
- 检查爬虫权限: 确保
误区五:用“机翻感”内容敷衍,忽视本地化语境与“实体绑定”
在 AI 的知识图谱中,每个知名品牌都是一个独立的“实体(Entity)”,并与特定的属性、品类、场景紧密相连。
许多出海品牌在生产英文或多语种内容时,直接用中文思维撰写再批量翻译。这会导致品牌使用的词汇与海外真实母语者的提问方式脱节。比如,欧美用户在询问 AI 时,往往会带上非常具体的生活场景(如 “best portable power station for CPAP machine while camping”——露营时为呼吸机供电的最佳便携电源)。如果你的内容里只有生硬的工业参数,没有海外本土生活场景的结合,AI 就很难建立起“你的品牌 = 某个具体需求解决方案”的实体关联。
- 破局策略: 深入海外本土真实语境,强化“品牌实体 + 细分场景”的强绑定。研究目标市场用户在 Reddit、Amazon Review 中的原声提问,用符合当地文化习惯的表达方式,将品牌植入到具体的痛点解决方案中。
结语:GEO 的本质,是成为 AI 眼中的“高信噪比信源”
不要把 GEO 看作是一场钻算法空子的投机游戏。生成式 AI 的终极目标是为用户提供最准确、最省心、最可靠的答案。
当你的品牌跳出“刷词、买链、自嗨”的传统怪圈,转而用真实的数据、清晰的逻辑结构、深度的场景绑定以及跨平台的真实口碑去武装自己的数字资产时,AI 自然会将你识别为那个不可替代的“最优解”,在亿万次海外用户的对话中,主动把你的品牌推向台前。
 豫公网安备 50010702500968号